 Jordy Herber
Een rustige Incident Queue geeft je pas vertrouwen als je kunt aantonen dat de detectieketen werkt. De bron moet events produceren, de juiste records moeten aankomen, de detectieregel moet uitvoeren en een relevante match moet bij een analist terechtkomen. Daarna moet ook de afgesproken response plaatsvinden. Als één van die stappen stopt, kan het scherm rustig blijven terwijl je zicht op aanvallen afneemt.
In mijn eerdere blog over Microsoft Sentinel in de Defender portal stond de overgang van het SOC centraal. De volgende stap is controleren of je detecties na die overgang blijven leveren wat je verwacht. Daarvoor heb je meer nodig dan een lijst met ingeschakelde regels. Je hebt een verwachting per databron en detectie nodig, plus bewijs dat die verwachting wordt gehaald.
Mijn advies is om detectiegezondheid als een eigen beheerproces in te richten. Koppel iedere belangrijke detectie aan haar databronnen, uitvoeringsschema, eigenaar en testscenario. Bewaak technische fouten én ontbrekend bewijs. Een regel met de status Success kan nul bruikbare events hebben onderzocht. Een playbook kan succesvol starten en daarna vastlopen bij het aanmaken van een ticket. Beide situaties vragen een andere controle.
We bouwen hieronder een aanpak voor een Microsoft 365 E5 demo tenant met een Azure subscription, een Log Analytics workspace met Microsoft Sentinel en een klein aantal testresources. De KQL gebruikt één expliciet gekozen workspace. De Azure subscription en het verbruik van Sentinel, Azure Monitor en Logic Apps staan los van de E5 licentie. De drempels in dit artikel zijn ontwerpvoorbeelden die je op je eigen aanvoer en responsetijden afstemt.
Kies eerst het type detectieregel
Deze verdieping gaat over Microsoft Sentinel analytics rules, met name Scheduled rules. Dat onderscheid telt in de Defender portal. Een custom detection is een ander regeltype met een andere beheerroute. Volgens de actuele Microsoft vergelijking zijn health logs voor analytics rules beschikbaar in SentinelHealth, terwijl vergelijkbare health logs voor custom detections nog als Planned staan vermeld. Je kunt de queries uit deze blog dus niet gebruiken als bewijs dat al je Defender custom detections worden bewaakt. Bron 1.
Begin je inventaris met een veld voor de detectievoorziening. Noteer bijvoorbeeld Sentinel Scheduled, Sentinel NRT of Defender custom detection. Leg ook de workspace vast waar de regel hoort. Een verplaatsing van de gebruikersinterface is geen bewijs dat iedere regel dezelfde telemetry, uitvoeringsidentiteit of automatisering gebruikt.
De technische basis van deze blog gebruikt de gedocumenteerde health en auditvoorzieningen voor Sentinel analytics rules. Microsoft markeert Analytics rule insights en Manual rerun als Preview. De Overview ervaring onder Data & connectors staat eveneens als Public preview beschreven. Ik gebruik die schermen als aanvullende hulpmiddelen. Het ontwerp blijft werken zonder ze, via logs, inventarisatie en afzonderlijke alarmen. Bronnen 2 en 3.
Definieer wat een gezonde detectie betekent
Voor deze aanpak splits ik gezondheid op in vijf controles. Iedere controle heeft een eigen bewijsstuk. Daarmee voorkom je dat een enkele groene status meer zekerheid suggereert dan de onderliggende meting geeft.
| Controle | Bewijs | Wat je hiermee nog niet bewijst |
| Databron | Verwachte events van verwachte systemen | Dat elk relevant eventtype is verzameld |
| Ingestie | Recente aankomst en acceptabele vertraging | Dat de detectielogica klopt |
| Uitvoering | Recente geslaagde uitvoering van de regel | Dat een aanval wordt herkend |
| Detectie | Bekende test levert de bedoelde alert | Dat alle aanvalspaden zijn afgedekt |
| Response | Verwachte actie aantoonbaar afgerond | Dat het volledige incident is opgelost |
Stel dat je een detectie hebt voor een risicovolle wijziging aan een account. Je verwacht auditdata, een uitvoering per vijf minuten en een incident met de juiste accountcontext. Leg afzonderlijk vast hoeveel vertraging je accepteert tussen bronactiviteit en aankomst, tussen aankomst en detectie en tussen detectie en opvolging. Tel die budgetten op voor je totale responsetijd. Een snelle query helpt weinig als de bron pas uren later levert.
Gebruik een inventaris die ook resources bevat waarvan je nog nooit een health event zag. Een query die alleen bestaande logs groepeert, kan geen resource tonen die volledig ontbreekt. Dit is de belangrijkste ontwerpkeuze in deze blog. De lijst met verwachte resources moet buiten de waargenomen events worden onderhouden.
Maak per regel minimaal de resource ID, het regeltype, de eigenaar, kritikaliteit, benodigde tabellen, uitvoeringsfrequentie, toegestane uitvoeringsachterstand en datum van de laatste functionele test bekend. Leg onderhoud met een begin en een eindtijd vast. Een uitzondering zonder eindtijd wordt in de praktijk al snel een permanente uitschakeling van je controle.
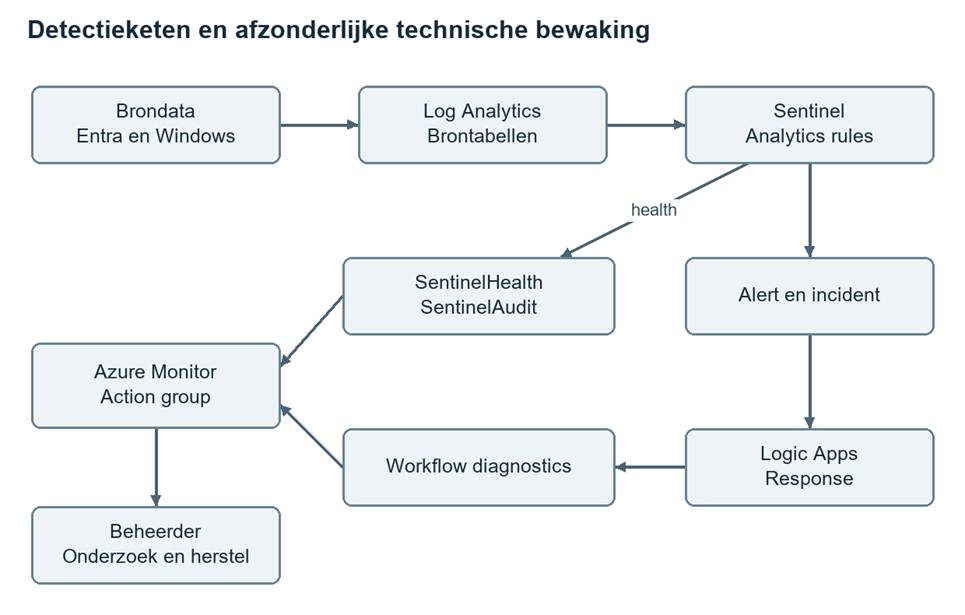
Figuur 1. Detectie en bewaking.
Het diagram toont twee beheerwegen. Operationele events doorlopen de detectie en response. Gezondheidsinformatie gaat daarnaast naar Azure Monitor. De tweede route deelt nog steeds Azure en de logopslag met de eerste. Je vermindert de afhankelijkheid van de Sentinel scheduler, maar bouwt hiermee geen volledig onafhankelijk monitoringsplatform.
Schakel auditing en health monitoring bewust in
Open in de Microsoft Defender portal System, Settings, Microsoft Sentinel, Auditing and health monitoring. Kies Enable voor de standaardconfiguratie naar de eigen workspace. Gebruik Configure diagnostic settings wanneer je de bestemmingen zelf wilt kiezen. Selecteer bij een handmatige configuratie allLogs als je analytics rules wilt meenemen. De tabellen ontstaan nadat het eerste relevante event is gegenereerd. Alleen analytics rules vallen op dit moment onder SentinelAudit. Bron 4.
Maak daarna een herkenbare wijziging aan de beschrijving van een labregel en laat die regel uitvoeren. Daarmee creëer je twee verschillende bewijzen. Je ziet een uitvoeringsrecord en een auditrecord. Alleen een knop met Enabled zegt nog niet of jouw querycontext de records kan lezen.
Gebruik in deze blog de Log Analytics querycontext van de gekozen Sentinel workspace. In de Defender portal bereik je de data via Investigation & response, Hunting, Advanced hunting, met de juiste Sentinel workspace geselecteerd. Controleer vooraf of de functies in die context beschikbaar zijn. Microsoft adviseert _SentinelHealth() en _SentinelAudit() voor compatibiliteit bij schemawijzigingen. Bron 5.
Codevoorbeeld 1. KQL.
_SentinelHealth()
| where TimeGenerated > ago(24h)
| summarize Records=count(), LastSeen=max(TimeGenerated)
by SentinelResourceType, SentinelResourceKind,
OperationName, Status
| order by LastSeen desc
Deze eerste query is bewust een inventarisatie van het werkelijke schema. Microsoft voorbeelden en tabellen gebruiken niet overal dezelfde schrijfwijze voor resource types. Baseer je filters daarom op de waarden die je in jouw workspace ziet. In de volgende health queries filter ik vooral op OperationName en gebruik ik waar passend een vergelijking die hoofdletters negeert. Verwijder afwijkende waarden niet stilzwijgend uit je overzicht.
Voer ook _SentinelAudit() met take 10 uit. Als een functie ontbreekt, controleer dan workspace, configuratie en beschikbare functies voordat je een diagnose stelt. Voor onderzoek kun je SentinelHealth of SentinelAudit rechtstreeks raadplegen. Zet niet automatisch een lege vervangtabel in een productiecontrole. Daarmee kan een ontbrekende bron veranderen in een ogenschijnlijk gezonde uitkomst.
SCREENSHOT 1. Toon Auditing and health monitoring en de gekozen workspace. Voeg een tweede uitsnede toe met de uitvoer van de inventarisatiequery, inclusief OperationName en LastSeen.
Controleer de aanvoer met een expliciete verwachting
Een connectorstatus en een recente tabel zijn twee verschillende metingen. SentinelHealth ondersteunt connectorgezondheid voor een selectie van connectors. De ondersteuning omvat onder meer Office 365 en connectors op basis van het Codeless Connector Framework. Stabiele fetchstatussen worden periodiek vastgelegd; bepaalde tijdelijke fouten krijgen eerst tijd om te herstellen. Gebruik connectorhealth daarom samen met een controle op de feitelijke data. Bron 3.
In een demo tenant kan een lage eventfrequentie normaal zijn. Een productietenant met continue interactieve aanmeldingen heeft een andere verwachting. Gebruik geen universele regel die iedere tabel na vijftien minuten zonder records als defect markeert. Kies de grens op basis van normaal gebruik, de beveiligingsfunctie van de bron en de afgesproken hersteltijd.
Onderstaande query bewaakt drie tabellen die in dit voorbeeld al bestaan. De vaste Expected tabel is de lijst die je wilt controleren. De leftouter join zorgt dat een tabel zonder records binnen het meetvenster zichtbaar blijft. Bij ontbrekende tabellen geeft de query een fout. Dat is een configuratieprobleem dat je eerst oplost, geen reden om de fout met isfuzzy te verbergen.
Codevoorbeeld 2. KQL.
let Expected = datatable(Source:string, MaxAgeMinutes:long)
[
“SigninLogs”, 30,
“AuditLogs”, 120,
“SecurityEvent”, 30
];
let Observed = union
(SigninLogs
| where TimeGenerated > ago(24h)
| extend Arrived=ingestion_time()
| summarize LastEvent=max(TimeGenerated),
LastArrival=max(Arrived), Records=count()
| extend Source=”SigninLogs”),
(AuditLogs
| where TimeGenerated > ago(24h)
| extend Arrived=ingestion_time()
| summarize LastEvent=max(TimeGenerated),
LastArrival=max(Arrived), Records=count()
| extend Source=”AuditLogs”),
(SecurityEvent
| where TimeGenerated > ago(24h)
| extend Arrived=ingestion_time()
| summarize LastEvent=max(TimeGenerated),
LastArrival=max(Arrived), Records=count()
| extend Source=”SecurityEvent”);
Expected
| join kind=leftouter Observed on Source
| extend EventAgeMinutes=
datetime_diff(“minute”, now(), LastEvent)
| extend ArrivalAgeMinutes=
datetime_diff(“minute”, now(), LastArrival)
| extend Health=case(
isnull(Records) or Records == 0, “NoDataInWindow”,
isnull(LastArrival), “ArrivalTimeUnavailable”,
LastEvent > now() + 5m, “CheckSourceClock”,
EventAgeMinutes > MaxAgeMinutes, “StaleEventTime”,
ArrivalAgeMinutes > MaxAgeMinutes, “StaleArrival”,
“WithinConfiguredBudget”)
| project Source, Records, LastEvent, LastArrival,
EventAgeMinutes, ArrivalAgeMinutes, MaxAgeMinutes,
Health
De query gebruikt twee tijdstippen omdat herstelde aanvoer oude events kan opleveren. LastArrival kan recent zijn terwijl LastEvent achterloopt. In die situatie is de transportstroom terug, maar ben je nog bezig met achterstand. Andersom kan een fout ingestelde bronklok een eventtijd in de toekomst opleveren. Markeer die situatie apart voordat je een lage vertraging als succes rapporteert.
Het filter op TimeGenerated beperkt hier bewust de scan tot events uit de laatste dag. Een batch met uitsluitend oudere events wordt daarmee niet als actuele dekking behandeld. Wil je backfill onderzoeken, voer dan een aparte query uit met een ruimer venster. Vergroot niet ongemerkt het bereik van iedere alarmquery naar maanden historie.
ingestion_time() is een benadering van het moment waarop een record beschikbaar kwam. De functie kan null opleveren en is geen betrouwbare sleutel voor exacte volgorde of een garantie op eenmalige verwerking. De query benoemt ontbrekende aankomsttijd daarom als een eigen toestand. Bron 6.
Een controle per tabel mist gedeeltelijke uitval. Als één domeincontroller blijft leveren en negen andere stoppen, blijft SecurityEvent recent. Breid de inventaris voor zulke bronnen uit met de verwachte Computer of resource ID. Laat vervolgens per systeem de nieuwste waarneming aansluiten op die lijst. Doe hetzelfde voor tenants, appliances, regio’s en werkruimten waar de dekking afzonderlijk moet worden aangetoond.
Meet vertraging voordat je een detectievenster kiest
De onderstaande query meet de verdeling van vertraging voor SigninLogs. Gebruik de percentielen als invoer voor je ontwerp. De grens van vijf minuten is een voorbeeld voor een onderzoeksvraag. Het is geen Microsoft garantie en ook geen universele norm voor deze tabel.
Codevoorbeeld 3. KQL.
SigninLogs
| where TimeGenerated between (ago(7d) .. now())
| extend Arrived=ingestion_time()
| extend DelaySeconds=
datetime_diff(“second”, Arrived, TimeGenerated)
| summarize
Total=count(),
MissingArrival=countif(isnull(Arrived)),
NegativeDelay=countif(DelaySeconds < 0),
P50=percentile(DelaySeconds, 50),
P95=percentile(DelaySeconds, 95),
P99=percentile(DelaySeconds, 99),
OverFiveMinutes=countif(DelaySeconds > 300)
by bin(TimeGenerated, 1h)
| order by TimeGenerated asc
Analyseer uren met ontbrekende waarden of negatieve vertraging afzonderlijk voordat je de percentielen gebruikt. Splits de meting verder uit als een specifieke toepassing, regio of bronklasse structureel achterloopt. Een gemiddelde over alle bronnen kan een kleine maar belangrijke bron met hoge vertraging verbergen.
Stel voor een eigen ontwerp dat een regel elke vijf minuten draait en dat je twintig minuten bronvertraging wilt opvangen. Dan kan een eventvenster van vijf minuten onvoldoende zijn. Microsoft beschrijft het vergroten van het eventvenster in combinatie met een filter op recente ingestie. Neem die aanpassing ook op in de Lookup data from the last instelling van de regel. Een breder tijdsfilter in alleen de query is geen vervanging voor de juiste regelconfiguratie. Bron 7.
Beschouw deduplicatie daarbij als een aparte eis. Overlappende vensters, retries en opnieuw aangeboden brondata kunnen hetzelfde zakelijke event meerdere keren zichtbaar maken. Bepaal een stabiele eventidentiteit en test hoe je regel, alertgroepering en response omgaan met herhaling. Controleer bij joins ook de traagste bron. Een snelle sign-in kan al zijn verwerkt voordat de bijbehorende auditactiviteit binnenkomt.
Een eenvoudige grens op dataversheid blijft nuttig naast een volumebaseline. Een procentuele daling kan relevant zijn bij continue aanvoer, maar weinig zeggen bij een bron die alleen tijdens wijzigingen events produceert. Begin met expliciete bronverwachtingen. Voeg pas daarna een baseline per uur en weekdag toe. Sla geplande veranderingen in logselectie op, zodat een bewuste daling in volume niet wekenlang een alarm blijft veroorzaken.
Onderzoek uitvoeringsfouten op regelniveau
De volgende query toont de laatste uitvoeringswaarneming per analytics rule. Je ziet de uitvoeringsstatus naast de aantallen queryresultaten en aangemaakte alerts. De velden komen uit ExtendedProperties en horen bij analytics rule health. Gebruik de resource ID als sleutel; een display name kan veranderen. Bron 8.
Codevoorbeeld 4. KQL.
_SentinelHealth()
| where TimeGenerated > ago(24h)
| where OperationName in~ (
“Scheduled analytics rule run”, “NRT analytics rule run”)
| summarize arg_max(TimeGenerated, *) by SentinelResourceId
| extend Results=tolong(ExtendedProperties.QueryResultAmount),
Alerts=tolong(ExtendedProperties.AlertsGeneratedAmount),
MappingDrops=tolong(
ExtendedProperties.EntitiesDroppedDueToMappingIssuesAmount)
| project TimeGenerated, SentinelResourceId,
SentinelResourceName, SentinelResourceKind, Status,
Reason, Results, Alerts, MappingDrops, Description
| order by TimeGenerated desc
Gebruik dit overzicht voor triage, niet als volledige inventaris. Regels zonder health events binnen de laatste dag ontbreken. Een regel die gisteren is verwijderd of weken geleden stopte, verdwijnt dus ook uit dit beeld. Verder vertelt de laatste geslaagde uitvoering niets over de kwaliteit van eerdere uitvoeringen. Bewaar voor incidentonderzoek het hele relevante tijdvenster.
Een Success met nul resultaten vraagt een inhoudelijke beoordeling. Controleer eerst of de brondata aanwezig was, daarna of de filters nog passen bij de actuele velden en waarden. Controleer ook de drempel, event grouping, suppression en incidentinstellingen van de regel. Een queryresultaat, een alert en een incident zijn drie verschillende uitkomsten. Meet ze apart.
Entiteiten verdienen een eigen controle. Een alert zonder de verwachte gebruiker of host kan technisch geldig zijn, terwijl triage en automatisering onvoldoende context krijgen. Maak de aanwezigheid van die entiteit onderdeel van je functionele test. Controleer na querywijzigingen ook de geprojecteerde kolomnamen, gegevenstypen en mapping. Kijk niet alleen naar het aantal gegenereerde alerts.
Bij een falende Scheduled rule maakt Microsoft onderscheid tussen tijdelijke fouten en fouten die ingrijpen vereisen. Permanente problemen, zoals een verdwenen functie of verloren toegang, kunnen tot automatisch uitschakelen leiden. Los eerst de oorzaak op voordat je een regel opnieuw inschakelt. Anders herstel je alleen de instelling en niet de werking. Bron 9.
SCREENSHOT 2. Toon een labregel met de laatste health records. Zet een geslaagde uitvoering met nul resultaten naast een uitvoering die testdata herkent. Laat ook de rule ID zien.
Bewaak uitvoeringen die volledig uitblijven
Een foutrecord is zichtbaar. Een regel die niet meer voorkomt vraagt om een vergelijking met een inventaris. Voor twee kritieke labregels gebruiken we hieronder een vaste lijst. Vervang de voorbeeldnamen tussen de dubbele quotes door de volledige resource IDs uit jouw omgeving. De getoonde MaxGapMinutes van dertig minuten is een voorbeeld voor regels die iedere vijf minuten horen te draaien.
Codevoorbeeld 5. KQL.
let Expected = datatable(
RuleId:string, RuleLabel:string, MaxGapMinutes:long)
[
“REPLACE_WITH_FULL_RULE_RESOURCE_ID_1”, “Identity lab”, 30,
“REPLACE_WITH_FULL_RULE_RESOURCE_ID_2”, “Endpoint lab”, 30
];
let Observed = _SentinelHealth()
| where TimeGenerated > ago(24h)
| where OperationName =~ “Scheduled analytics rule run”
| extend RuleId=tolower(SentinelResourceId)
| summarize LastSeen=max(TimeGenerated),
LastSuccess=maxif(TimeGenerated, Status =~ “Success”)
by RuleId;
Expected
| extend RuleId=tolower(RuleId)
| join kind=leftouter Observed on RuleId
| extend AgeMinutes=
datetime_diff(“minute”, now(), LastSuccess)
| extend Health=case(
isnull(LastSeen), “NoExecutionEvidence”,
isnull(LastSuccess), “NoSuccessInWindow”,
AgeMinutes > MaxGapMinutes, “SuccessTooOld”,
“WithinConfiguredBudget”)
| where Health != “WithinConfiguredBudget”
| project RuleId, RuleLabel, Health,
LastSeen, LastSuccess, AgeMinutes, MaxGapMinutes
De query levert alleen afwijkingen op. Daardoor past hij bij een alarm op het aantal resultaatrijen groter dan nul. Hij blijft een regel tonen wanneer de bijbehorende health records buiten het meetvenster vallen. De oorzaak kan de regel zijn, maar ook de telemetry. Gebruik daarom de formulering geen uitvoeringsbewijs totdat je de oorzaak hebt vastgesteld.
Laat de inventaris niet uitsluitend bestaan uit regels die nu Enabled zijn. Een onbedoeld uitgeschakelde regel zou dan direct uit je verwachting verdwijnen. Bewaar een goedgekeurde gewenste toestand en vergelijk die met de actuele configuratie. Maak een geautoriseerde wijziging zichtbaar met een wijzigingsreferentie, verantwoordelijke en einddatum voor tijdelijke uitzonderingen.
Voor een regel die maar één keer per dag hoort te draaien, zijn een venster van 24 uur en een grens van dertig minuten ongeschikt. Gebruik een ruimere analyseperiode en een eigen budget. De voorbeelden werken met frequente labregels om de test snel observeerbaar te maken. Neem het schema en de vertraging van de health telemetry mee wanneer je een productiedrempel kiest.
Let bij een onderliggende storing op het aantal meldingen. Honderden regels kunnen tegelijk geen recente Success meer tonen. Open dan één platformincident met de getroffen regels als bijlage, plus aparte escalaties voor detecties met een kortere herstelafspraak. De herkenning van de gemeenschappelijke oorzaak hoort bij je routering, niet bij het verbergen van individuele afwijkingen.
Haal de actuele regelconfiguratie op met PowerShell
Voor een grotere omgeving wil je de inventaris regelmatig vergelijken met de actuele resources. Dit voorbeeld leest de alert rules via de Microsoft Sentinel REST API. Het gebruikt API versie 2025-09-01 en volgt nextLink als de response over meerdere pagina’s is verdeeld. Het script wijzigt geen regels. Bronnen 10 en 11.
Codevoorbeeld 6. POWERSHELL.
# Vereist Az.Accounts en leesrechten op de workspace.
Connect-AzAccount
$subscriptionId = ‘REPLACE_WITH_SUBSCRIPTION_ID’
$resourceGroup = ‘rg-sentinel-lab’
$workspaceName = ‘law-sentinel-lab’
Set-AzContext -SubscriptionId $subscriptionId | Out-Null
$workspaceId = “/subscriptions/$subscriptionId” +
“/resourceGroups/$resourceGroup” +
‘/providers/Microsoft.OperationalInsights/workspaces/’ +
$workspaceName
$requestUri = ‘https://management.azure.com’ + $workspaceId +
‘/providers/Microsoft.SecurityInsights/alertRules’ +
‘?api-version=2025-09-01’
$items = [System.Collections.Generic.List[object]]::new()
do {
$response = Invoke-AzRestMethod -Method GET -Uri $requestUri
if ($response.StatusCode -ne 200) {
throw “Ophalen mislukt. HTTP $($response.StatusCode)”
}
$page = $response.Content | ConvertFrom-Json
foreach ($rule in $page.value) { $items.Add($rule) }
$requestUri = $page.nextLink
} while ($requestUri)
$inventory = foreach ($rule in $items) {
if ($rule.kind -notin @(‘Scheduled’, ‘NRT’)) { continue }
[pscustomobject]@{
RuleId = $rule.id.ToLowerInvariant()
DisplayName = $rule.properties.displayName
Kind = $rule.kind
Enabled = $rule.properties.enabled
Frequency = $rule.properties.queryFrequency
Lookback = $rule.properties.queryPeriod
Suppression = $rule.properties.suppressionEnabled
ExportedAtUtc = [DateTime]::UtcNow.ToString(‘o’)
}
}
$inventory | Export-Csv -LiteralPath ‘.\sentinel-rule-inventory.csv’ `
-NoTypeInformation -Encoding utf8
$inventory | Format-Table DisplayName, Kind, Enabled, Frequency
Bewaar de export met een tijdstip en koppel hem aan de juiste tenant en workspace. Het bestand is een momentopname. Een succesvolle export zegt niets over een wijziging die vijf minuten later plaatsvindt. Combineer daarom periodieke configuratiecontrole met auditmonitoring en de controle op ontbrekend uitvoeringsbewijs.
Voor geautomatiseerde uitvoering gebruik je een beheerde identiteit of een andere beheerde authenticatieroute met beperkte leesrechten. Vermijd een interactieve beheeraccount als structurele afhankelijkheid. Leg vast wie de inventaris beheert en wie wijzigingen in de gewenste toestand goedkeurt. Laat het uitvallen van de inventarisexport zelf ook een melding opleveren.
Een regel met een ongewijzigde querytekst kan toch anders werken. Denk aan aangepaste functies, watchlists, bronvelden, toegangsrechten en gewijzigde datasets. Neem die afhankelijkheden op in je beheerregistratie. Een export van alleen de rule resource is geen volledige versie van de detectieomgeving.
Bekijk retries per venster
Microsoft beschrijft voor Scheduled rules herhaalde pogingen op hetzelfde venster. Een enkele mislukte poging bewijst daardoor niet dat de volledige detectie voor dat venster is gemist. Kijk of een latere poging alsnog slaagde. Houd Scheduled en NRT gescheiden, omdat hun herstelgedrag verschilt. Bron 12.
De volgende analyse groepeert uitvoeringen op resource ID en het geregistreerde QueryStartTimeUTC. Het resultaat toont vensters waarvoor in de bekeken data wel fouten en geen Success aanwezig zijn. De wachttijd van dertig minuten is een gekozen onderzoeksmarge. Dit is geen bewijs dat Microsoft alle retries al heeft afgerond.
Codevoorbeeld 7. KQL.
_SentinelHealth()
| where TimeGenerated > ago(24h)
| where OperationName =~ “Scheduled analytics rule run”
| extend WindowStart=
todatetime(ExtendedProperties.QueryStartTimeUTC)
| where isnotnull(WindowStart)
| summarize FirstSeen=min(TimeGenerated),
LastSeen=max(TimeGenerated),
Successes=countif(Status =~ “Success”),
Failures=countif(Status =~ “Failure”),
Reasons=make_set(Reason, 10)
by SentinelResourceId, WindowStart
| where Failures > 0 and Successes == 0
| where LastSeen < ago(30m)
| order by WindowStart asc
Gebruik dit resultaat om de exacte uitvoeringsrecords te openen. Kijk naar record IDs, queryvenster en oorzaak. Dubbele export van telemetry of een onvolledig analysevenster kan de interpretatie beïnvloeden. Baseer een productiemaatstaf voor gemiste vensters daarom op gevalideerde recordidentiteit en op het bewezen gedrag van de regels die je meet.
Voor een herstelonderzoek leg je het eerste en laatste getroffen venster vast. Vergelijk daarna met de bewaarde brondata. Als de bron nooit is verzameld, kun je het detectiegat niet oplossen door alleen opnieuw te queryen. Als de brondata wel aanwezig is, kun je een gerichte historische analyse uitvoeren en zo nodig extra alerts of incidenten laten onderzoeken.
Gebruik Manual rerun alleen met kennis van de bijwerkingen. Een herhaalde regeluitvoering kan opnieuw werk veroorzaken in je incidentproces. Test eerst met een labregel en begrens de automatische response. Controleer of je ticketkoppeling en andere acties herhaling herkennen. De Preview functie is een hulpmiddel voor herstel, geen vervanging voor je eigen herstelprocedure. Bron 2.
Volg configuratiewijzigingen tot de verantwoordelijke
Een detectie kan technisch blijven uitvoeren terwijl iemand de drempel verhoogt, een filter toevoegt of de incidentinstelling verandert. SentinelAudit maakt wijzigingen aan analytics rules onderzoekbaar. Onderstaande query toont de identiteit en gewijzigde eigenschappen naast de operatie. De volledige voor en na toestand blijft beschikbaar voor verdieping. Bron 13.
Codevoorbeeld 8. KQL.
_SentinelAudit()
| where TimeGenerated > ago(7d)
| where OperationName in~ (
“Microsoft.SecurityInsights/alertRules/Write”,
“Microsoft.SecurityInsights/alertRules/Delete”)
| extend Caller=tostring(ExtendedProperties.CallerName),
CallerIp=tostring(ExtendedProperties.CallerIpAddress),
Changed=tostring(ExtendedProperties.ResourceDiffMemberNames)
| project TimeGenerated, SentinelResourceId,
SentinelResourceName, OperationName, Status,
Caller, CallerIp, Changed, CorrelationId, Description
| order by TimeGenerated desc
Beoordeel een Write niet automatisch als kwaadwillend. Vergelijk de operatie met de goedgekeurde wijziging en de gebruikte deploymentidentiteit. Een bekende identiteit kan een verkeerde configuratie uitrollen. Een onbekende identiteit kan een toegestane noodwijziging doen. Je hebt de combinatie nodig van actor, doelresource, wijziging, tijdstip en autorisatie.
Maak een aparte escalatie voor het verwijderen van een kritieke regel en voor wijzigingen die detectie verminderen. Denk aan Enabled, querytekst, drempel, frequentie, lookback, suppression en benodigde entiteiten. Ga niet uit van één vaste JSON structuur binnen OriginalResourceState en UpdatedResourceState. Inspecteer de records in jouw omgeving voordat je daar veldpaden en vergelijkingen op bouwt.
Een actueel configuratieoverzicht blijft nodig naast auditing. Als auditverzameling tijdelijk uitstaat, ontbreekt een deel van het wijzigingsverhaal. Een vergelijking tussen gewenste en actuele toestand kan de afwijking alsnog vinden. Andersom verklaart alleen de actuele toestand niet wie een instelling heeft gewijzigd. Deze controles vullen elkaar aan.
SCREENSHOT 3. Toon een auditrecord van een gecontroleerde beschrijvingswijziging. Laat CallerName, ResourceDiffMemberNames en de twee resource states zien. Verwijder accountgegevens die je niet wilt publiceren.
Controleer of de response ook wordt afgerond
SentinelHealth kan aantonen dat een automation rule een playbook heeft gestart. Dat bewijst nog niet dat de workflow klaar is of dat de afzonderlijke acties slagen. Verzamel ook Logic Apps diagnostics. Voor de hieronder gekozen route worden workflowevents naar AzureDiagnostics gestuurd. Bron 14.
Controleer per Logic App in Azure de Diagnostic settings en de Log Analytics bestemming. Voer daarna één test uit en inspecteer de ontvangen kolommen. Sommige configuraties gebruiken een andere tabelroute, waaronder LogicAppWorkflowRuntime. Die heeft eigen kolommen zoals RunId, WorkflowId en Status. Gebruik de query hieronder alleen voor de AzureDiagnostics route met de getoonde velden. Bron 15.
De query bewaart gestarte runs waarvoor nog geen eindrecord is gevonden. Daarvoor is een leftouter join nodig. Een inner join zou juist de runs zonder eindbewijs wegfilteren. Dat zijn de runs die je vaak wilt onderzoeken.
Codevoorbeeld 9. KQL.
let Starts = _SentinelHealth()
| where TimeGenerated > ago(24h)
| where OperationName =~ “Automation rule run”
| mv-expand Playbook=ExtendedProperties.TriggeredPlaybooks
| extend RunId=tostring(Playbook.RunId),
WorkflowId=tolower(tostring(Playbook.WorkflowId))
| where isnotempty(RunId) and isnotempty(WorkflowId)
| summarize StartedAt=min(TimeGenerated)
by RunId, WorkflowId;
let Ends = AzureDiagnostics
| where TimeGenerated > ago(24h)
| where OperationName =~
“Microsoft.Logic/workflows/workflowRunCompleted”
| extend RunId=tostring(resource_runId_s),
WorkflowId=tolower(_ResourceId),
FinalStatus=tostring(status_s)
| summarize arg_max(TimeGenerated, FinalStatus)
by RunId, WorkflowId
| project RunId, WorkflowId, EndedAt=TimeGenerated, FinalStatus;
Starts
| join kind=leftouter Ends on RunId, WorkflowId
| extend Outcome=case(
isempty(FinalStatus) and StartedAt < ago(30m),
“NoCompletionEvidenceAfterBudget”,
isempty(FinalStatus), “WaitingForCompletionEvidence”,
FinalStatus =~ “Succeeded”, “WorkflowSucceeded”,
“InspectWorkflowOutcome”)
| project StartedAt, EndedAt, WorkflowId, RunId,
FinalStatus, Outcome
Valideer vooraf of WorkflowId uit de Sentinel record en _ResourceId uit AzureDiagnostics dezelfde resource aanwijzen. Laat voor één bekende run beide bronrecords naast elkaar zien. Als de identifiers anders worden vastgelegd, corrigeer dan de normalisatie. Laat een onjuiste join niet veranderen in honderden foutieve meldingen over ontbrekende afronding.
Deze query behandelt alleen playbooks die in TriggeredPlaybooks van automation rule events voorkomen. Handmatig gestarte playbooks en andere triggerroutes vragen hun eigen startinventaris. Controleer ook automation events met Failure of Partial success. Bij een mislukte trigger staat er geen geslaagde start in de lijst waarop deze query aansluit.
Een workflow met Succeeded kan nog steeds een fout hebben afgehandeld zonder het gewenste zakelijke resultaat te leveren. Voeg daarom in je ontwerp een eindcontrole toe. Een ticketflow moet bijvoorbeeld het ticketnummer kunnen teruggeven en het ticket teruglezen. Een containmentflow moet de werkelijke toestand van het doelobject verifiëren. Bewaar een correlatie ID waarmee je incident, workflowrun en resultaat kunt verbinden.
SCREENSHOT 4. Toon één automation event naast de bijbehorende Logic Apps run. Gebruik een labrun waarin de trigger slaagt en een vervolgstap faalt. Toon ook het resultaat van de correlatiequery.
Maak een alarmroute buiten de analytics rules
Mijn ontwerp gebruikt Azure Monitor log search alerts voor technische bewaking. Daarmee laat je een probleem met Sentinel Scheduled rules niet uitsluitend door een andere Sentinel Scheduled rule melden. De logopslag en Azure Monitor blijven gedeelde afhankelijkheden. Voeg voor kritieke omgevingen daarom een aparte periodieke controle toe die bevestigt dat het monitoringsproces zelf nog draait en meldingen werkelijk aankomen.
Maak in Azure Monitor via Alerts, Create, Alert rule een regel met de Sentinel workspace als scope. Kies Custom log search. Gebruik als eerste alarm de query met Expected regels en ontbrekend uitvoeringsbewijs. Configureer Table rows groter dan nul, een evaluatiefrequentie van vijf minuten en een expliciet querybereik van 24 uur dat overeenkomt met de analyse. Controleer in Preview dat historische laatste uitvoeringen nog worden meegenomen. Gebruik RuleId als stabiele dimensie en koppel een Action group. Bron 16.
Een onbedoeld klein querybereik in de alarmconfiguratie kan een gezonde regel als ontbrekend tonen. De portalinstellingen zijn daarom onderdeel van je configuratie, net als de KQL. Bewaar beide. Test na iedere wijziging aan het venster of een regel met een uitvoering buiten de laatste vijf minuten nog correct wordt beoordeeld.
Kies voor deze labopzet een melding na twee opeenvolgende afwijkende evaluaties. Dit is een gekozen ruismaatregel. De werkelijke detectietijd bestaat ook uit het leeftijdsbudget van de query, de evaluatieplanning en telemetryvertraging. Een MaxGapMinutes van dertig en twee evaluaties per vijf minuten leveren geen garantie op een melding binnen tien minuten na uitval.
Gebruik een Action group test om de bestemming te controleren, maar voer daarnaast een echte grensoverschrijding uit. Een geslaagde notificatietest bewijst niet dat de logquery, dimensies en drempel goed zijn ingesteld. Test ook herstel. Leg vast wanneer het alarm weer gezond mag worden en of een herstelmelding bij de beheerder aankomt.
Bewaar per melding de workspace, resource ID, eigenaar, laatst geslaagde waarneming en link naar de onderzoekquery. Gebruik geen veranderend tijdstip als dimensie. Dat kan iedere evaluatie een andere alarminstantie maken. Houd de identiteit van een storing stabiel zolang dezelfde resource met hetzelfde probleem blijft zitten.
Een onderhoudsperiode moet meldingen kunnen dempen zonder de metingen weg te gooien. Na het einde moet de controle automatisch hervatten. Controleer dat een langlopende storing na onderhoud alsnog zichtbaar wordt. Een handmatig uitgeschakelde alarmregel met een afspraak om hem later weer aan te zetten is onvoldoende beheersing.
Bewijs de werking met gecontroleerde storingsproeven
Voer de volgende proeven uit op labresources met een eigenaar en een herstelstap. Verander één onderdeel tegelijk. Noteer begin, verwachte detectietijd, waargenomen melding, herstelactie en tijdstip waarop de keten weer aantoonbaar werkte. De verwachte resultaten hieronder zijn testcriteria, geen gemeten resultaten uit jouw tenant.
| Proef | Wijziging in het lab | Verwacht bewijs |
| Uitvoering ontbreekt | Schakel één geïnventariseerde labregel tijdelijk uit | Auditwijziging en later een melding over ontbrekend uitvoeringsbewijs |
| Bron valt stil | Onderbreek alleen de verzameling van een labbron | Afwijking in bronversheid, ook wanneer andere bronnen leveren |
| Logica mist events | Voeg een niet passende filterwaarde toe | Uitvoering slaagt maar de positieve detectietest faalt |
| Entiteit ontbreekt | Verwijder een benodigde projectiekolom in een labkopie | Mappingprobleem of ontbrekende verwachte entiteit |
| Response faalt | Gebruik in een labplaybook een gecontroleerde Failed eindstatus | Startbewijs aanwezig en afronding met afwijkende status |
| Monitoring herstelt | Herstel de gewijzigde component | Nieuwe succesvolle test en correct herstel van de melding |
Voor de eerste proef exporteer je de labregel en noteer je de resource ID. Controleer dat hij in Expected staat. Schakel de regel uit, wacht tot je gekozen budget en evaluatievoorwaarden zijn overschreden en controleer de notificatie. Schakel hem daarna weer in. Sluit de test pas af wanneer een nieuwe geslaagde uitvoering is geregistreerd en de alarmtoestand is hersteld.
Voor de bronproef controleer je vooraf welke andere detecties dezelfde bron gebruiken. Onderbreek alleen de labroute. Het doel is te zien of de meting op het juiste niveau werkt. Als je een enkele labhost stopt terwijl andere hosts blijven leveren, moet de controle per host afgaan. Een alarm dat uitsluitend naar de totale tabel kijkt, zal dit scenario terecht niet herkennen.
Voor de logicaproef laat je een bekende positieve test mislukken door een filter te veranderen. Houd de query syntactisch geldig. Je wilt juist aantonen dat technische uitvoering en functionele herkenning verschillende controles zijn. Herstel de filter en herhaal exact hetzelfde scenario. Gebruik een herkenbaar testkenmerk dat je later uit rapportages kunt scheiden zonder de detectie te omzeilen.
Voor de responseproef gebruik je een afzonderlijk playbook met een expliciete Failed eindstatus na de trigger. Koppel het uitsluitend aan het labscenario. Controleer zowel de triggertelemetry als de workflowuitkomst. Je hoeft hiervoor geen productieverbinding te verbreken of rechten van een gedeelde identiteit in te trekken.
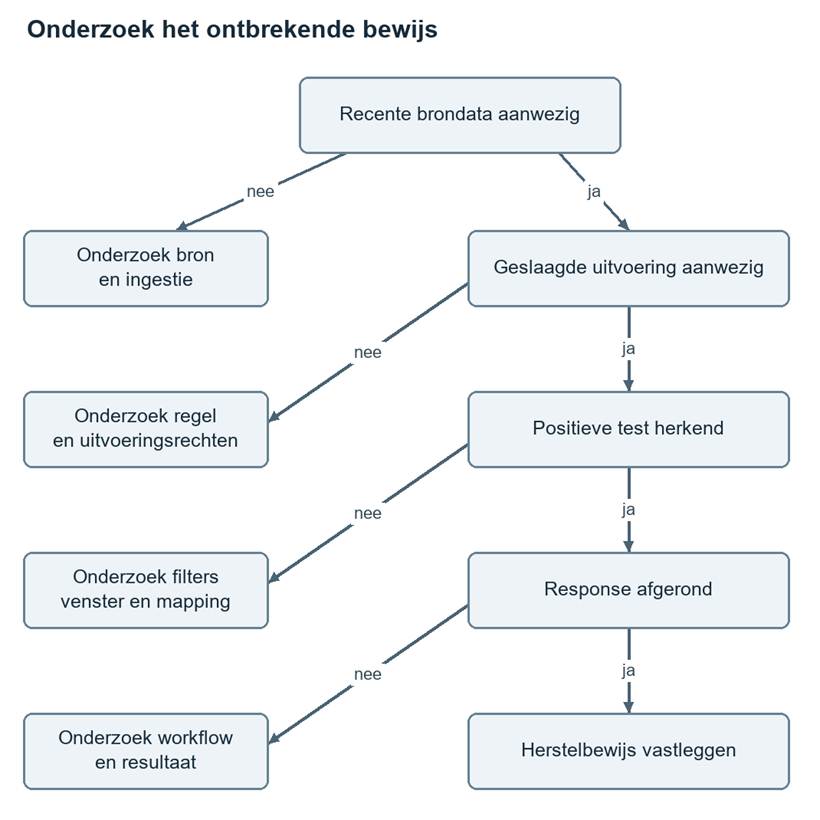
Figuur 2. Onderzoeksvolgorde.
De beslisboom voorkomt dat iedere afwijking direct als een defecte regel wordt behandeld. Begin met het ontbrekende bewijs en onderzoek vervolgens de stap die dat bewijs moet leveren. Bewaar de originele foutdetails. Een screenshot met alleen een rode status is onvoldoende om later te begrijpen wat er is hersteld.
Voeg een herkenbare functionele ketentest toe
Een periodieke controle op configuratie en health blijft onvolledig zonder positieve test. Voor een Windows labhost met SecurityEvent ingestie kun je een geplande aanmelding met een uitsluitend voor tests gebruikte account gebruiken. De exacte accountnaam en host moeten overeenkomen met jouw ontvangen records. Onderstaande query selecteert één combinatie die je eerst handmatig verifieert.
Codevoorbeeld 10. KQL.
SecurityEvent
| where TimeGenerated > ago(30m)
| where EventID == 4624
| where Computer =~ “lab-dc01.contoso.example”
| where TargetUserName =~ “sentinel-health-test”
| project TimeGenerated, Computer, TargetUserName,
TargetDomainName, LogonType, EventID
Maak hiervoor een afzonderlijke Scheduled labregel met een herkenbare naam, bijvoorbeeld ITCowboys Sentinel ketentest. Gebruik een lage ernst, een frequentie van vijf minuten, een lookback van dertig minuten en een drempel groter dan nul. Koppel een onschadelijke actie zoals het toevoegen van een testlabel of het registreren van een testresultaat. Controleer bij de accountmapping de domeincontext. Bron 17 beschrijft het aanmaken van Scheduled analytics rules.
Dit voorbeeld kan hetzelfde event in meerdere overlappende uitvoeringen terugzien. Het is bedoeld om de route aantoonbaar te testen. Ontwerp voor een blijvende periodieke test een unieke testidentiteit per uitvoering, deduplicatie en een registratie van verwachte tests. Een productiealarm mag niet alleen kijken of er ooit een testalert was. Vergelijk de geplande test met het bijbehorende bronrecord, de alert en het afgeronde testresultaat.
Voeg ook een negatieve test toe. Een aanmelding met een andere account of op een andere host hoort deze specifieke testregel niet te activeren. Daarmee controleer je of de filters werkelijk onderscheid maken. Controleer daarna of het testlabel niet leidt tot automatische sluiting voordat de gewenste bewijsvorming is afgerond.
Deze ketentest bewijst alleen de gekozen Windows route. Hij bewijst geen aanvoer van Entra sign-ins, firewalllogs of Microsoft 365 auditactiviteiten. Maak per kritieke gegevensroute een passende, onschadelijke test. Houd de tests klein en voorspelbaar, zodat ze de operationele wachtrij niet vullen en je bronbelasting beperkt blijft.
Werk vanuit een vast onderzoeksproces
Wanneer een melding binnenkomt, leg je eerst de scope vast. Welke workspace, regel en databron zijn geraakt. Controleer het laatste goede bewijs en de eerste afwijking. Kijk vervolgens of meerdere resources tegelijk uitvallen. Dat bepaalt of je één detectie onderzoekt of een probleem met gedeelde infrastructuur.
Controleer daarna wijzigingen in de betrokken periode. Neem naast de regel ook functies, connectorinstellingen, credentials, rechten en diagnostische instellingen mee. Herstel geen oude configuratie zonder te begrijpen waarom die was aangepast. Een recente wijziging kan een noodzakelijke beveiligingsverbetering zijn waarvan een afhankelijkheid nog niet is bijgewerkt.
Gebruik voor herstel een volgorde die opnieuw bewijs oplevert. Herstel de bron of configuratie, bevestig actuele aanvoer, laat de regel uitvoeren, voer de functionele test uit en controleer de response. Een handmatig als opgelost gemarkeerd ticket is geen vervanging voor deze stappen. Leg het herstelbewijs vast bij hetzelfde incident.
| Waarneming | Eerste onderzoek | Herstelbewijs |
| Alle tabellen worden oud | Gedeelde ingestie, workspace en queryscope | Nieuwe bronrecords uit meerdere routes |
| Eén bron wordt oud | Connector, bronactiviteit en bronrechten | Verwachte events van die specifieke bron |
| Data actueel maar geen Success | Regelstatus, functies en uitvoeringsfouten | Nieuwe geslaagde uitvoering |
| Success maar positieve test gemist | Filters, venster, drempel en suppression | Alert met de bedoelde testcontext |
| Alert zonder juiste entiteit | Projectie en entity mapping | Alert met de verwachte gebruiker of host |
| Workflow gestart zonder resultaat | Diagnostics, run history en eindcontrole | Afgeronde actie met teruggelezen resultaat |
Sluit af met een beoordeling van het detectiegat. Noteer vanaf wanneer je geen betrouwbare dekking meer kon aantonen en welke aanvallen of activiteiten daardoor onvoldoende zichtbaar waren. Bepaal of historische analyse nodig is. Gebruik de aanwezige brondata en de exacte tijdvensters. Vermeld expliciet wanneer ontbrekende aanvoer zo’n reconstructie beperkt.
Maak beheer meetbaar zonder schijnzekerheid
Rapporteer voor kritieke detecties de duur zonder uitvoeringsbewijs, de duur zonder actuele brondata en de uitkomst van de laatste functionele test. Houd onbekend als aparte status. Een bron waarvoor geen verwachting is vastgelegd, hoort niet automatisch bij gezond. Hetzelfde geldt voor een detectie waarvan de laatste testdatum ontbreekt.
Een percentage succesvolle uitvoeringen is nuttig, maar de noemer moet de verwachte uitvoeringen bevatten. Als je alleen ontvangen health records telt, verdwijnen ontbrekende uitvoeringen uit het percentage. Bewaar daarom per regel de verwachte frequentie en onderhoudsperioden. Publiceer naast het percentage ook hoeveel regels nog buiten de meting vallen.
Maak onderscheid tussen detectieuitval en herstelwerk. Een bron kan weer leveren terwijl de achterstand nog wordt ingehaald. Een regel kan weer draaien terwijl historische vensters nog niet zijn beoordeeld. Een workflow kan weer tickets maken terwijl eerder gemiste tickets nog moeten worden hersteld. Gebruik deze verschillen in de status van het beheerincident.
Houd kosten en toegang bij het ontwerp betrokken. Microsoft beschrijft SentinelHealth ingestie als niet factureerbaar en SentinelAudit als factureerbaar. Aanvullende opslag, query’s, alerts en Logic Apps kunnen eigen kosten hebben. Beperk brede scans, gebruik expliciete tabellen en kies bewaartermijnen passend bij onderzoek en beheer. Bron 5.
Toegang tot een workbook is nog geen garantie op toegang tot alle onderliggende data. Test de onderzoekqueries ook met de rol van de dienstdoende analist. Een beheerder die alles kan zien, kan een toegangsprobleem in het dagelijkse proces missen. Documenteer de benodigde leesrechten per workspace en de bevoegdheid om herstel uit te voeren.
Controleer dit voordat je de bewaking overdraagt
De inventaris bevat alle kritieke analytics rules, inclusief de gewenste ingeschakelde toestand. Iedere regel heeft een eigenaar, databronnen, uitvoeringsbudget en testscenario. De health en auditverzameling is met echte labrecords bevestigd. De datacontroles onderscheiden ontbrekende records, oude eventtijd en ontbrekende aankomsttijd.
De alarminrichting gebruikt hetzelfde querybereik als de bedoelde analyse. De melding heeft een stabiele resourceidentiteit en komt bij de juiste beheerder aan. Onderhoud heeft een eindtijd. Er is een aparte controle op het uitvallen van de inventarisatie en de meldroute. Een fout in de monitorquery wordt onderzocht en niet als nul afwijkingen weergegeven.
Voor iedere kritieke route is een positieve en negatieve test uitgevoerd. Een uitgeschakelde labregel is herkend, een stilgevallen labbron is zichtbaar geworden en een gefaalde response is correct gerapporteerd. Herstel is met nieuwe events en een nieuwe ketentest bevestigd. De testregistratie bevat de gemeten tijden, zonder die te verwarren met de gekozen ontwerpgrenzen.
Mijn advies voor je SOC
Begin met vijf kritieke detecties en werk de bewaking daarvan volledig af. Kies detecties met verschillende databronnen en minstens één geautomatiseerde opvolgactie. Maak voor die selectie zichtbaar wat je verwacht, welk bewijs je ontvangt en wie een afwijking oplost. Breid pas uit wanneer de meldingen bruikbaar zijn en de herstelprocedure werkt.
De kwaliteit zit in de koppeling tussen verwachting en bewijs. Een actuele tabel, een geslaagde query en een gestarte workflow zijn elk nuttige signalen. Samen met een gecontroleerde functionele test geven ze je een onderbouwd beeld van de detectieketen. Zo kun je uitleggen waarom een rustige Incident Queue vertrouwen verdient, of waarom je eerst een storing moet oplossen.
Volg ITCowboys voor de volgende technische deep dive. In de komende blogs pak ik meer Microsoft Security, XDR, Sentinel, Identity en Purview onderwerpen op vanuit de praktijk.