 Jordy Herber
Een migratie van Microsoft Sentinel naar de Microsoft Defender portal raakt de dagelijkse afhandeling van incidenten. Je analisten krijgen een andere werkplek, terwijl koppelingen met ticketsystemen, detectieregels en playbooks dezelfde uitkomst moeten blijven leveren. Mijn advies is om de overgang te behandelen als een wijziging van je SOC dienstverlening. Maak aantoonbaar dat een melding aankomt, bij de juiste analist terechtkomt en met de juiste context wordt afgehandeld.
Microsoft ondersteunt Sentinel na 31 maart 2027 niet meer in de Azure portal. De datum juli 2026 uit oudere communicatie is dus achterhaald. Sentinel in de Defender portal is algemeen beschikbaar, ook zonder Microsoft Defender XDR of een E5 licentie. Dit concept gebruikt de stand van Microsoft Learn op 13 oktober 2026. Bron 1.
We werken met een Microsoft 365 E5 demotenant, een Azure abonnement en een bestaande Log Analytics workspace waarop Sentinel actief is. E5 is hier de labkeuze voor de gecombineerde ervaring. Het is geen voorwaarde voor Sentinel in de Defender portal. Azure verbruik en de inrichting van logging blijven afzonderlijke aandachtspunten. Het doel is een controleerbare migratie met concrete acceptatiecriteria voor engineers en analisten.
Begin bij de dienstverlening van het SOC
Leg eerst vast wat je SOC vandaag levert. Welke incidenten hebben een responstijd van vijftien minuten. Welke meldingen gaan naar een externe dienstverlener. Welke acties vereisen beoordeling door een analist. Maak per proces duidelijk wie eigenaar is en welk bewijs aantoont dat het proces werkt. Zo voorkom je dat de technische aansluiting het enige criterium voor succes wordt.
Maak een inventaris met workspaces, databronnen, analytics rules, automation rules, Logic Apps en externe koppelingen. Voeg ook opgeslagen zoekopdrachten, workbooks en werkinstructies toe. Noteer bij iedere afhankelijkheid de gebruikte velden. Een ticketkoppeling die een titel als sleutel gebruikt, vraagt een andere test dan een koppeling die een incidentidentificatie opslaat. Een query met een vaste providernaam verdient extra aandacht.
Mijn voorstel is om gedurende zeven dagen voor de wijziging een nulmeting te verzamelen. Meet aantallen alerts per bron, incidenten per ernst, tijd tot toewijzing, mislukte playbooks en ontbrekende ticketverwijzingen. Zeven dagen is een werkafspraak voor dit migratieplan, geen Microsoft eis. Vergelijk na de wijziging dezelfde weekdagen en bedrijfsuren. Gebruik een drukke servicedag niet als vergelijking voor een rustige zondag.
Begrijp de architectuur voordat je aansluit
De bestaande Log Analytics opslag blijft onderdeel van Sentinel. De overgang verandert onder meer de manier waarop je incidenten onderzoekt en signalen samenkomen. Het architectuurdiagram laat daarom afzonderlijk de logaanvoer, detectie, incidentafhandeling en automatisering zien. Het is een logisch model. Het tekent geen fysieke datacenterlocaties of volledige interne Microsoft verwerkingsketen. Bron 2.
Kies bewust welke workspace primair wordt. Microsoft koppelt Defender XDR incidenten en alerts aan die primaire workspace. Secundaire workspaces blijven afzonderlijk werken voor incidentvorming en correlatie. Een gezamenlijke incidentlijst betekent dus niet dat alerts uit alle workspaces automatisch in hetzelfde incident belanden. Bron 3.
Maak voor iedere workspace een eigenaar verantwoordelijk voor de brondekking. Denk aan een centrale workspace voor het SOC en een aparte workspace voor een zelfstandige bedrijfseenheid. Controleer dan expliciet waar de Defender alerts terechtkomen. Een lokale detectieregel die voorheen op een eigen kopie van die alerts vertrouwde, heeft een aangepaste gegevensroute of detectieopzet nodig.
Neem gegevensopslag ook mee in de ontwerpbespreking. Bij bestaande CMK versleuteling blijven workspace logs volgens Microsoft met de eigen sleutel versleuteld. Voor alerts en incidenten verandert dit na onboarding. Laat de verantwoordelijke voor gegevensbescherming de relevante opslagvoorwaarden beoordelen voordat je aansluit. Bron 2.
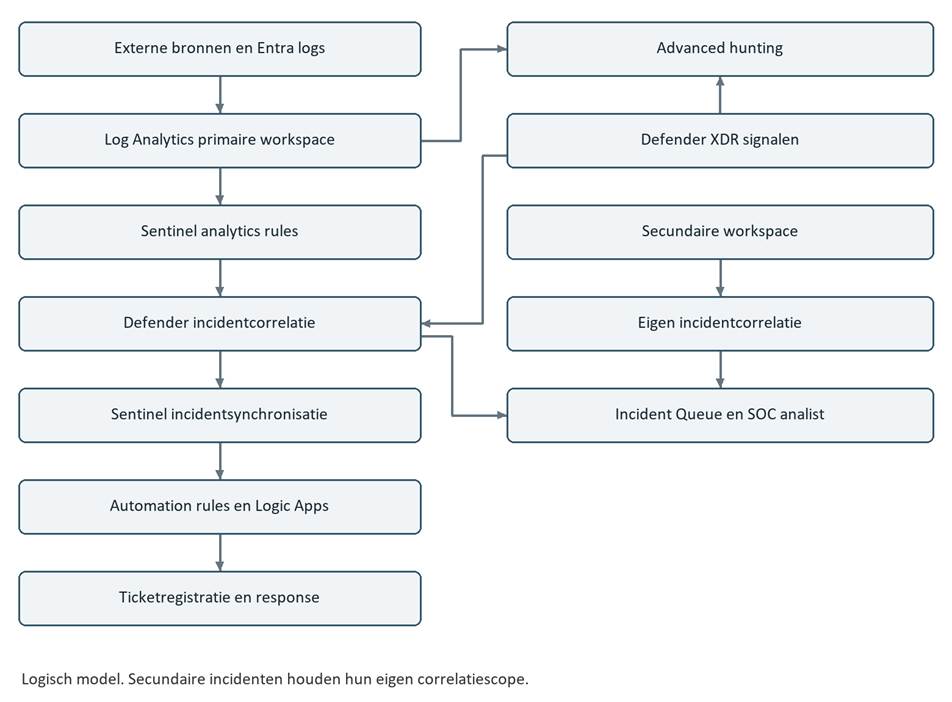
Figuur 1. Logisch architectuurmodel van de migratie. De Mermaid bron staat in de redactionele bijlage.
Richt rechten in per taak
Gebruik voor de aansluiting een tijdelijk beheeraccount met de voorgeschreven rechten. De onboardingdocumentatie noemt Security Administrator in Microsoft Entra ID, gecombineerd met een onvoorwaardelijke Owner toewijzing op abonnementsniveau, of de beschreven combinatie van User Access Administrator en Microsoft Sentinel Contributor. Controleer de exacte scope voor jouw situatie in bron 4. Geef een analist deze beheerrechten niet om een ontbrekende knop op te lossen.
Maak vervolgens drie testaccounts. Een lezer mag incidenten bekijken. Een analist mag de afgesproken onderzoekshandelingen uitvoeren. Een engineer beheert detectie en automatisering. Test ieder account in een eigen browsersessie. Noteer ook wat het account niet mag zien of wijzigen. Alleen een succesvolle test met een beheerder zegt weinig over de dagelijkse toegang van het team.
Azure RBAC blijft relevant voor Sentinel. Behandel eventuele activering van Unified RBAC als een eigen wijziging met een eigen rechtenmatrix. Bron 4. Test toegang tot een incident, de onderliggende logs en de responseactie afzonderlijk. Een zichtbare incidentkaart bewijst niet dat de analist alle bijbehorende gegevens kan onderzoeken.
Voor IdentityInfo vraagt de overgang extra controle. De migratiehandleiding beschrijft verschillen in schema en het ontbreken van tabelniveau RBAC voor de native Defender versie. Bron 2. Neem daarom ook een negatieve test op voor een account dat in de oude situatie geen identiteitsgegevens mocht lezen. Leg het resultaat vast voordat je de werkplek breed beschikbaar maakt.
Sluit de workspace gecontroleerd aan
Open security.microsoft.com. Kies onder System achtereenvolgens Settings, Microsoft Sentinel en Connect a workspace. Selecteer de workspaces, kies Next en wijs de primaire workspace aan. Lees de productwijzigingen en kies daarna Connect. Controleer na aansluiting de workspaceweergave. Deze route komt uit de onboardinghandleiding. Bron 4.
Plan dit moment samen met de dienstdoende analist. Stop tegelijk uitgevoerde wijzigingen aan detecties en ticketkoppelingen voor de duur van de migratietest. Leg het tijdstip in UTC vast en noteer wie de wijziging uitvoert. Die registratie helpt later bij het vergelijken van logs, incidenten en uitvoeringen van Logic Apps.
Neem schermafbeelding 1 op bij deze stap. Toon de geselecteerde primaire workspace en de verbonden status. Gebruik alleen de demotenant. De afbeelding moet duidelijk maken welke workspace de centrale incidentstroom ontvangt. Een screenshot met alleen een groene status is onvoldoende als de gekozen workspace buiten beeld blijft.
Voer na aansluiting direct een leescontrole uit met het analistenaccount. Open een bestaand incident, voer een opgeslagen query uit en bekijk een recente gebeurtenis van een externe databron. Controleer vervolgens een nieuw testincident. Bestaande gegevens kunnen zichtbaar zijn terwijl nieuwe verwerking faalt. Beide controles horen bij het bewijs voor een geslaagde aansluiting.
Controleer connectoren op inhoud
De XDR connectorroute kan alertvelden veranderen. Microsoft beschrijft onder meer wijzigingen in ExtendedProperties en CompromisedEntity. Bij Defender for Identity bevat dat laatste veld via XDR de letterlijke waarde CompromisedEntity. Je kunt dat veld dus niet algemeen behandelen als een gebruikersnaam of apparaatnaam. Bron 5.
Controleer per product een alert van voor en na de overgang. Vergelijk niet alleen of de rij bestaat. Bekijk de entiteiten, ernst, productnaam, tijdstippen en aanvullende eigenschappen. Maak een kleine verzameling geanonimiseerde voorbeeldrecords voor de engineer die de koppelingen onderhoudt. Noteer welke velden verplicht zijn voor de eigen verwerking en wat er gebeurt wanneer een veld ontbreekt.
Microsoft documenteert ook bronafhankelijke filtering. Voor Entra ID worden standaard geen alerts onder High ingelezen via deze route, tenzij je de configuratie uitbreidt. Informational alerts van Defender for Cloud worden niet ingelezen via de XDR connector. Bron 5. Een lager volume vraagt daarom onderzoek naar filtering voordat je concludeert dat de omgeving rustiger is geworden.
Mijn advies is om ontbrekende waarden zichtbaar te maken in plaats van ze stil te vervangen door onbekend. Laat een ticketkoppeling een foutregistratie maken wanneer een vereiste entiteit ontbreekt. Geef die registratie een eigenaar. Anders verschijnt een technisch geslaagde uitvoering in het overzicht, terwijl het aangemaakte ticket te weinig informatie bevat voor onderzoek.
Test incidentvorming met herkenbare scenario’s
Tijdens onboarding kun je volgens Microsoft kiezen voor Retain Sentinel incident creation behavior for XDR alerts. Controleer daarna onder Settings, Microsoft Defender XDR en Alert grouping de overgenomen regels. Latere wijzigingen aan Sentinel groepering worden niet doorlopend naar Defender gesynchroniseerd. Bron 6.
Maak voor de acceptatietest drie scenario’s. Het eerste scenario bevat één alert met één gebruiker. Het tweede bevat meerdere gerelateerde alerts rond dezelfde gebruiker en hetzelfde apparaat. Het derde bevat twee losstaande gebeurtenissen. Schrijf vooraf op welke behandeling je verwacht. Voer alleen goedgekeurde tests in de demotenant uit. Je hebt voor deze controle geen schadelijke aanval nodig.
Bekijk na iedere test de alertkoppelingen, incidenttoewijzing en ticketuitkomst. Beoordeel of een samengevoegd incident bij de juiste eigenaar blijft. Controleer ook of het ticketsysteem een bestaande registratie bijwerkt wanneer de incidentcontext verandert. De naam van een incident hoort in de presentatie, maar is ongeschikt als vaste technische sleutel.
Spreek af wie de regie voert bij een incident met zowel identiteitsproblemen als endpointmeldingen. Laat één analist de voortgang bewaken en andere specialisten hun onderzoek toevoegen. Maak overdracht expliciet in de werkinstructie. Het aantal incidenten kan dalen door andere groepering, terwijl het aantal betrokken alerts gelijk blijft. Gebruik die daling daarom niet zelfstandig als bewijs van betere detectie.
Maak automatisering bestand tegen vertraagde updates
Automation rules werken met triggers, voorwaarden en acties. De volgorde telt, omdat een eerdere actie de toestand kan wijzigen waarop een volgende regel controleert. Microsoft vermeldt ook dat meerdere incidentwijzigingen binnen vijf tot tien minuten als één update naar Sentinel kunnen gaan. Tussenliggende wijzigingen gaan dan verloren. Bron 7.
Ontwerp jouw ticketkoppeling daarom rond de actuele toestand. Laat de workflow eerst het bestaande ticket opzoeken, daarna de huidige incidentgegevens ophalen en vervolgens alleen noodzakelijke wijzigingen doorvoeren. Sla een combinatie van tenant, workspace waar relevant en incidentidentificatie op. Gebruik een aparte registratie voor uitgevoerde acties. Dat helpt voorkomen dat dezelfde responseactie opnieuw wordt gestart na een herhaalde melding.
Test dit door in de demotenant kort achter elkaar eigenaar, ernst en status te wijzigen. Controleer vervolgens of het ticket de laatste toestand weergeeft. Eis niet dat iedere tussenstap als afzonderlijk triggerbericht aankomt. Als jouw auditproces iedere wijziging nodig heeft, moet je daarvoor een afzonderlijk gecontroleerd auditmechanisme ontwerpen.
De migratiehandleiding noemt tot tien minuten vertraging voordat een automation rule draait. Bron 2. Meet deze tijd als apart onderdeel van de totale responstijd. Een afspraak van vijftien minuten vraagt ruimte voor detectie, synchronisatie, uitvoering en menselijk handelen. Maak die tijdsbesteding zichtbaar in de acceptatietest.
Controleer ook de afhandeling van een mislukte externe aanvraag. Een tijdelijke storing in het ticketsysteem mag geen onbegrensde stroom nieuwe tickets opleveren. Gebruik begrensde herhaalpogingen, registreer het laatste resultaat en zorg voor een zichtbare foutmelding aan het beheerteam. Test herstel nadat de koppeling weer beschikbaar is.
KQL voor een betrouwbare incidenttelling
SecurityIncident bevat incidentrecords met onder meer IncidentName, IncidentNumber, Status en LastModifiedTime. Bron 8. Voor een telling wil je per incident de nieuwste beschikbare toestand gebruiken. Onderstaande query reduceert de opgehaalde records daarom eerst met arg_max. Voer de query uit tegen één geselecteerde Sentinel workspace. Zo voorkom je dat de betekenis van de identificatie wordt vermengd met gegevens uit andere workspaces.
Stel de tijdselectie in op minimaal dertig dagen. De query telt incidenten die binnen dat venster een record hebben. Een oud open incident zonder record binnen dit venster ontbreekt. Gebruik de uitkomst dus voor een migratievergelijking met dezelfde scope, niet als gegarandeerd volledig overzicht van alle open zaken. Vergroot het venster als de retentie en je onderzoeksvraag dat vragen.
Controleer enkele incidenten handmatig in de portal voordat je een dashboard op deze query baseert. Een afwijking tussen aantallen verdient eerst onderzoek naar scope, tijdvenster en synchronisatie. Voeg pas daarna een verklaring toe aan de rapportage. Een managementgrafiek moet duidelijk aangeven of zij incidenten, alerts of gewijzigde incidentrecords telt.
SecurityIncident
| where TimeGenerated >= ago(30d)
| summarize arg_max(TimeGenerated, *) by IncidentName
| summarize Incidenten=count() by Status, Severity
| order by Incidenten desc
KQL voor veranderde alertvelden
De tweede query onderzoekt SecurityAlert in dezelfde workspace. Zij bewaart per SystemAlertId het nieuwste record binnen zeven dagen en groepeert daarna op product en provider. De telling LeegEntiteit toont hoe vaak CompromisedEntity ontbreekt. Deze velden staan in de Microsoft tabelreferentie. Bron 9.
Vergelijk de uitvoer met een opgeslagen nulmeting van voor de migratie. Een leeg veld is niet automatisch een connectorstoring. Het wordt een functioneel probleem zodra jouw playbook, query of tickettemplate dat veld verplicht gebruikt. Controleer daarom de onderliggende records van het product dat afwijkt.
Deze query detecteert geen ontbrekende databron. Als een product helemaal geen alerts levert, verschijnt het ook niet in de groepering. Houd naast het queryresultaat een verwachte bronnenlijst bij. Laat een engineer expliciet aftekenen dat iedere vereiste bron aanwezig is of een verklaarde reden heeft om geen alerts te leveren.
SecurityAlert
| where TimeGenerated >= ago(7d)
| summarize arg_max(TimeGenerated, *) by SystemAlertId
| summarize Alerts=count(),
LeegEntiteit=countif(isempty(CompromisedEntity))
by ProductName, ProviderName
| order by Alerts desc
KQL voor logaanvoer en vertraagde ingestie
De derde query gebruikt SigninLogs en vergelijkt TimeGenerated met ingestion_time. SigninLogs bevat de aanmeldingsgegevens die je via de ingestelde Entra logging aanlevert. Bron 10. De query toont per uur het volume en een benadering van de vertraging tot ingestie. Die vertraging bevat meer dan alleen portalverwerking. Je meet hiermee geen tijd tot incidentvorming.
Gebruik de uitkomst om een onderbreking rond het migratiemoment te onderzoeken. Een uur zonder rij betekent dat de query geen gebeurtenissen voor dat uur teruggeeft. Het bewijst niet zelfstandig dat de connector defect is. Controleer de bronactiviteit, de juiste workspace, ingestieconfiguratie en tijdselectie. Vergelijk bij lage volumes een langere periode.
Filter vroeg op tijd en beperk daarna de uitvoer tot de velden die je nodig hebt. Dat maakt de query leesbaar voor de analist die tijdens een dienst een storing moet uitzoeken. De voorbeelden zijn onderzoeksqueries. Ze zijn geen direct inzetbare custom detection rules en bevatten geen complete configuratie voor planning, entiteitskoppeling of automatische response.
SigninLogs
| where TimeGenerated >= ago(24h)
| extend IngestieTijd=ingestion_time()
| extend VertragingSeconden=
datetime_diff(‘second’, IngestieTijd, TimeGenerated)
| summarize Records=count(),
P95Seconden=percentile(VertragingSeconden, 95),
LaatsteIngestie=max(IngestieTijd)
by bin(TimeGenerated, 1h)
| order by TimeGenerated asc
ingestion_time geeft een benadering en kan null teruggeven als de vereiste ingestietijdregistratie ontbreekt. Gebruik de waarde niet om een exacte gebeurtenisvolgorde vast te stellen. Bron 12.
Advanced hunting vraagt aandacht voor de uitvoercontext
In Advanced hunting kun je Sentinel gegevens naast Defender gegevens onderzoeken. Die zichtbaarheid betekent niet dat alle Defender ruwe data ook in Log Analytics staat. Voor gebruik vanuit Sentinel blijft ingestie van die data een afzonderlijke configuratie. Bron 11. Noteer bij iedere gedeelde query de bedoelde uitvoeromgeving en benodigde tabellen.
Controleer de workspacekeuze rechtsboven voordat je een resultaat beoordeelt. Het multiworkspace document noemt aparte beperkingen voor onder meer custom detections en queries via de API. Bron 3. Een query die interactief werkt, vormt daarom geen bewijs dat dezelfde logica in iedere automatiseringsroute inzetbaar is.
Microsoft beschrijft voor gestreamde Defender tabellen ook verschillen tussen Timestamp en TimeGenerated. Gebruik voor het oorspronkelijke Defender gebeurtenistijdstip Timestamp. Bij gefilterde ingestie naar Sentinel kan een tijdvoorwaarde in de query de geselecteerde gegevens beïnvloeden. Controleer dan het advies over de tijdselectie in de queryeditor. Bron 11.
Mijn advies is om aan iedere onderzoeksquery drie regels documentatie toe te voegen. Beschrijf de onderzoeksvraag, de databronnen en de betekenis van een leeg resultaat. Laat een tweede analist de query uitvoeren zonder mondelinge toelichting. Als die analist de scope verkeerd begrijpt, moet de documentatie eerst worden aangepast.
Laat analisten de nieuwe werkwijze oefenen
Plan een oefening waarin een analist een incident van begin tot eind afhandelt. Start bij de Incident Queue, open de betrokken entiteiten, controleer aanvullende logs en leg een onderzoeksbevinding vast. Laat daarna een tweede analist de zaak overnemen. Die overdracht toont of de relevante context vindbaar is en of de nieuwe werkinstructie voldoende houvast biedt.
Gebruik schermafbeelding 2 voor het incident en schermafbeelding 3 voor de querycontext. Toon steeds hetzelfde labscenario, zodat de lezer de relatie tussen brongegevens en incident begrijpt. Verwijder tenantidentificaties, echte gebruikersnamen, publieke IP adressen en ticketgegevens die niet voor publicatie bedoeld zijn.
Oefen ook een incident dat buiten de expertise van de eerste analist valt. Een endpointanalist moet weten wanneer een identiteitspecialist nodig is. Leg vast hoe je die specialist betrekt zonder het eigenaarschap onduidelijk te maken. Meet de tijd tot de eerste inhoudelijke beoordeling en bespreek welke informatie ontbrak.
Beoordeel de migratie samen met de mensen die avonden en weekenden werken. Zij kunnen niet altijd direct een engineer bereiken. Een bruikbare werkinstructie beschrijft daarom ook wat de analist doet wanneer de ticketkoppeling vertraagd is, een query geen rechten heeft of een playbook niet start.
Werk met meetbare acceptatie en een herstelplan
Gebruik vooraf afgesproken criteria. Mijn voorstel is dat alle geselecteerde testmeldingen terugvindbaar zijn, iedere kritieke databron recente gegevens levert en geen test tot een onbedoeld dubbel ticket leidt. Laat ieder testaccount precies de afgesproken handelingen uitvoeren. Leg voor afwijkingen een eigenaar en een hersteltermijn vast. Deze criteria zijn een voorstel voor jouw project, geen door Microsoft opgelegde norm.
Maak onderscheid tussen teruggaan en herstellen. Het loskoppelen van een workspace van de Defender portal verbreekt volgens Microsoft ook de Defender XDR connectorverbinding wanneer die is geconfigureerd. Wie weer XDR incidenten in Sentinel wil ontvangen, moet die verbinding herstellen. Bron 4. Een herstelplan moet dus de gegevensaanvoer controleren nadat de portalverbinding is aangepast.
Bewaar voor de wijziging exports of vastgelegde versies van de relevante configuratie. Noteer connectorinstellingen, regelvoorwaarden, workflowversies en ticketmappings. Maak duidelijk welke engineer welke onderdelen herstelt. Test het plan in de demotenant en registreer welke stappen handmatig zijn. Een document met alleen het woord rollback is geen uitvoerbaar herstelplan.
Houd na de overgang dagelijks een korte review gedurende de afgesproken nazorgperiode. Bekijk foutmeldingen, onverwachte groepering, ontbrekende velden en analistenfeedback. Rond de migratie af wanneer de meetpunten stabiel zijn en het SOC de werkwijze kan uitvoeren. Een geslaagde aansluitknop is daarvoor onvoldoende bewijs.
Mijn advies voor jouw migratie
Begin met de processen die direct invloed hebben op response. Controleer eerst de primaire workspace, het incidentmodel en de ticketkoppeling. Pak daarna querycompatibiliteit, rapportages en de werkinstructies aan. Houd optionele vernieuwing buiten dezelfde wijziging wanneer je daardoor niet meer kunt verklaren waarom een resultaat verandert.
De basismogelijkheid om Sentinel in de Defender portal te gebruiken is algemeen beschikbaar. Functies zoals Simple Flows staan in de geraadpleegde documentatie als preview. Bron 7. Gebruik zulke functies in een afzonderlijke proef met eigen acceptatiecriteria. Controleer de status opnieuw vlak voor productiegebruik en publicatie.
Je haalt het meeste uit deze overgang wanneer je de volledige afhandeling kunt aantonen. De bron levert gegevens, de detectie vindt het juiste signaal, het incident krijgt een eigenaar en de response laat controleerbaar bewijs achter. Laat engineers en analisten samen die route testen. Daarmee maak je duidelijk wat de nieuwe werkplek voor jouw SOC verandert.
Volg ITCowboys voor de volgende technische deep dive. In de komende blogs pak ik meer Microsoft Security, XDR, Sentinel, Identity en Purview onderwerpen op vanuit de praktijk.